Stable Diffusion
コンシューマーGPUでローカル実行できる基礎的なオープンソーステキスト→画像モデル。カスタムモデル、LoRAファインチューニング、ControlNetの広大なエコシステムを支えています。
Stable Diffusionは、Ludwig Maximilian University of MunichのMachine Vision and Learning Group(CompVis)の研究者たちが、Stability AI、Runway ML、LAIONと協力して開発したオープンソースの深層学習テキスト→画像生成モデルです。2022年8月にすべてのモデルウェイトをオープンソースライセンスで公開し、DALL-E 2(クローズドAPI)やMidjourney(クローズドプラットフォーム)と根本的に異なります。
基礎技術は潜在拡散モデル(LDM)で、完全なピクセル空間ではなく圧縮された潜在空間でデノイジング拡散プロセスを実行します。この圧縮により計算コストが大幅に削減され、最適化バージョンが最小2.4GB VRAMのコンシューマーグレードGPUで実行できます。
コミュニティは2つの革新的なアドオンを生み出しました: 小規模データセットでの効率的なファインチューニングのためのLoRA(低ランク適応)と、深度マップ、エッジ検出、ポーズスケルトンなどの構造的入力を使用した空間条件付き生成を可能にするControlNetです。
主な機能
- 2.4GB VRAMのコンシューマーグレードGPUでローカル展開を可能にする完全オープンソースのモデルウェイト
- 計算効率のための潜在拡散アーキテクチャ — ピクセル空間モデルより高速な生成
- LoRAファインチューニング: コンシューマーハードウェアで数時間以内に20〜30枚の画像からパーソナライズされたモデルアドオンを訓練
- 深度マップ、ポーズスケルトン、エッジ検出などを使用した空間条件付けのためのControlNet
- 領域特定の編集とキャンバス拡張のためのインペインティングとアウトペインティング
- スタイル転送ワークフローのための調整可能なデノイジング強度を持つ画像→画像生成
- 不要な要素やアーティファクトを排除するネガティブプロンプトサポート
- SD 3.5 Large: 写実的品質で最大1メガピクセルの画像を生成する80億パラメータモデル
- 複数のUIフロントエンド: AUTOMATIC1111 WebUI、ComfyUI、InvokeAI、Fooocus
- すべての視覚スタイルをカバーするCivitaiとHugging Faceの大規模コミュニティモデルエコシステム
よくある質問
Stable Diffusionは無料で使えますか?
はい、Stable Diffusionは完全無料でオープンソースです。サブスクリプション料金や使用料なしにコンピューターにローカルでダウンロードして実行できます。基本的な使用には最低4GB VRAMのGPUが必要です。また、DreamStudioなどのクラウドプラットフォームが1000クレジット$10からの従量課金を提供し、Civitaiなどの無料Webインターフェースも多数存在します。
Stable Diffusionは日本語プロンプトに対応していますか?
Stable Diffusionは最適な結果のために主に英語プロンプトで動作します。一部のファインチューニングモデルは基本的な日本語テキストを理解できますが、ベースモデルは主に英語の説明で学習されています。最良の結果のために英語プロンプトを使用してください。日本語ユーザーは通常、説明を英語に翻訳するか翻訳ツールを使用します。
Stable Diffusionはどんな人に向いていますか?
Stable Diffusionは、AI画像生成の完全な制御を望む技術に精通したユーザー、開発者、デジタルアーティスト、プライバシー重視のクリエイターに最適です。カスタムモデル、LoRA、ControlNetによるカスタマイズを重視するユーザーに魅力的です。研究者や企業はライセンスの心配なく製品に統合できるオープンソースの特性から恩恵を受けます。
Stable Diffusionの最大の利点は何ですか?
Stable Diffusionの最大の利点は、完全無料、オープンソース、ローカル実行可能な点です。サブスクリプション費用なしの無制限生成、画像がコンピューターから出ない完全なプライバシー、コミュニティ制作のモデルやLoRA、拡張機能による前例のないカスタマイズを提供します。AUTOMATIC1111やComfyUIなどのツールエコシステムは、クローズドソースの代替品を凌駕する機能を提供します。
Stable Diffusionは初心者でも簡単に使えますか?
Stable Diffusionはクラウドベースの代替品よりも学習曲線が急です。ローカルインストールにはGPUセットアップやPython環境設定などの技術的知識が必要です。ただし、AUTOMATIC1111やComfyUIなどのユーザーフレンドリーなWeb UIがプロセスを大幅に簡素化しています。DreamStudioやCivitaiなどのクラウドオプションは、ローカルセットアップをスキップしたい初心者に簡単なブラウザベースのアクセスを提供します。
代替ツール
画像生成の他のツール

Adobe Firefly
画像生成Adobe Fireflyは、ライセンスコンテンツで学習した商用利用安全な生成AI画像ツールで、Photoshop、Illustrator、Adobe Expressに深く統合されたプロ向けクリエイティブワークフローを提供します。
アートブリーダー
画像生成遺伝的アルゴリズムで画像を育種・混合する協力的AIアートツール
ブルーウィロー
画像生成最良の結果のためのマルチモデルルーティングを使用したDiscordベースの無料AI画像ジェネレーター
クレヨン
画像生成アカウント不要でどのブラウザでもアクセスできる無料AI画像ジェネレーター
DALL-E
画像生成自然言語の説明から詳細な画像を生成するOpenAIの先駆的なテキスト→画像AIファミリー。業界最高のテキストレンダリング精度とChatGPT統合が特徴。
ドリームスタジオ
画像生成Stability AIからの高度なコントロールを持つ公式Stable Diffusionウェブインターフェース
タグ
関連ガイド

AI建築パース・リノベーション提案画像の作り方2026:Midjourney・Firefly・Stable Diffusion・Kreaで誤解を生まない合意形成
現況資料、変更禁止領域、段階生成、図面・仕様・見積との差分管理を通じて、AI建築パースを完成保証ではなく合意形成に使う方法を解説します。

AI漫画背景の作り方2026:Stable Diffusion・Midjourney・Krea・Fireflyで構図ラフから入稿前チェックまで
最終更新日:2026年7月30日 · カテゴリークラスター:AI画像生成ツール 漫画背景で時間がかかるのは、建物を一枚きれいに描くことではありません。 同じ部屋を別の角度から見せ、人物の足を床に置き、吹き出しの場所を空け、前のコマと昼夜や小物をつなぎ、最後に線数とトーンを作品へ合わせる作業です。生成AIは一枚絵には強くても、この連続性を自動で守ってはくれません。…
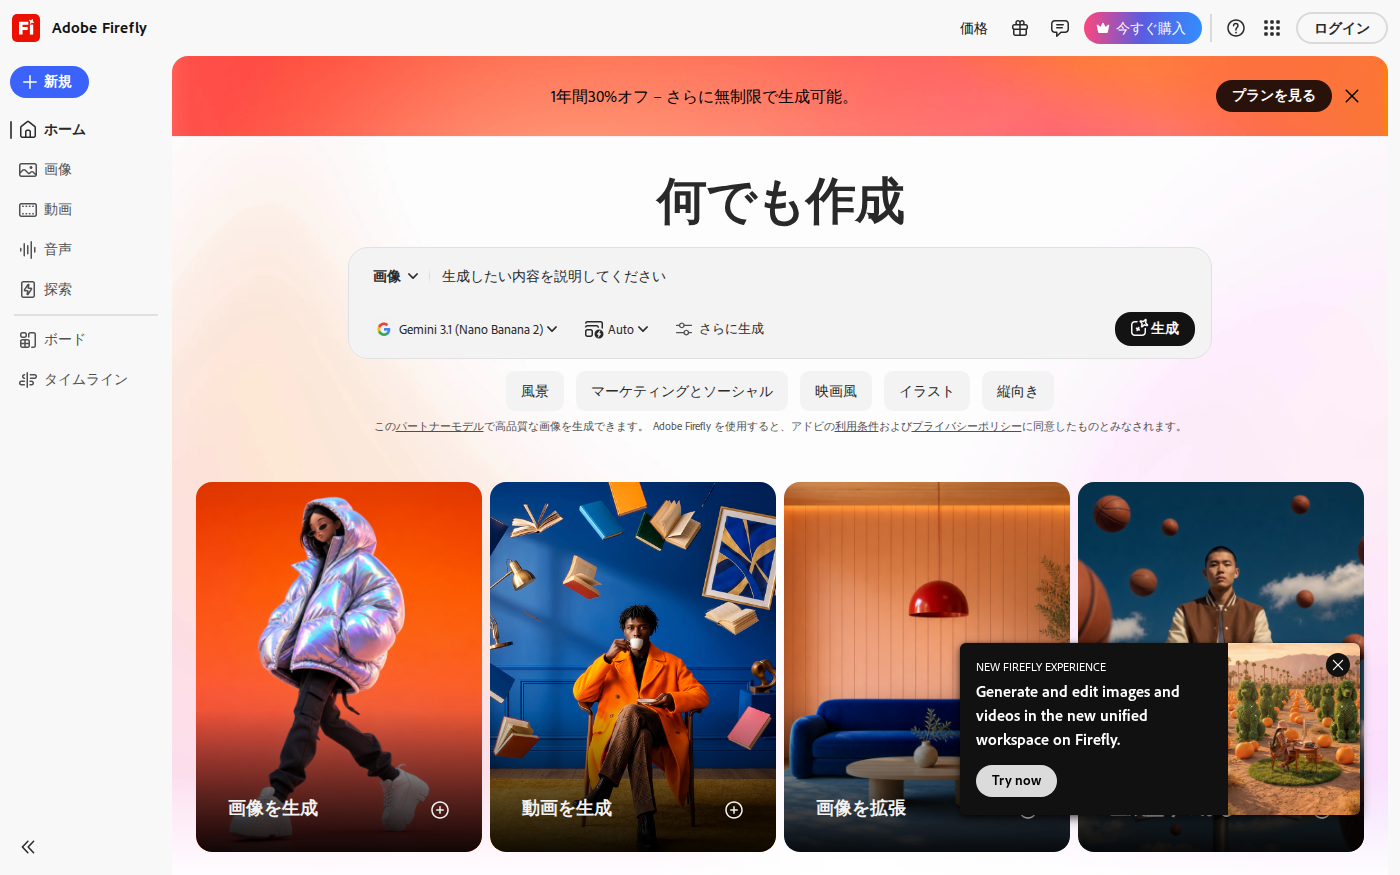
Adobe Fireflyは商用利用できる?Adobeモデルとパートナーモデルの違い
確認日: 2026-08-26 · 画像生成AIツール Adobe FireflyのAdobe製モデルで生成したコンテンツは、商用目的に使用できます。アドビの日本向け公式ページは、Adobe Fireflyモデルの出力を商品の販売、印刷物やデジタル販促物、商品・サービスの販売に使えると説明しています。ただし、Fireflyの画面で作ったものがすべて同じ条件になるわけではありません。…
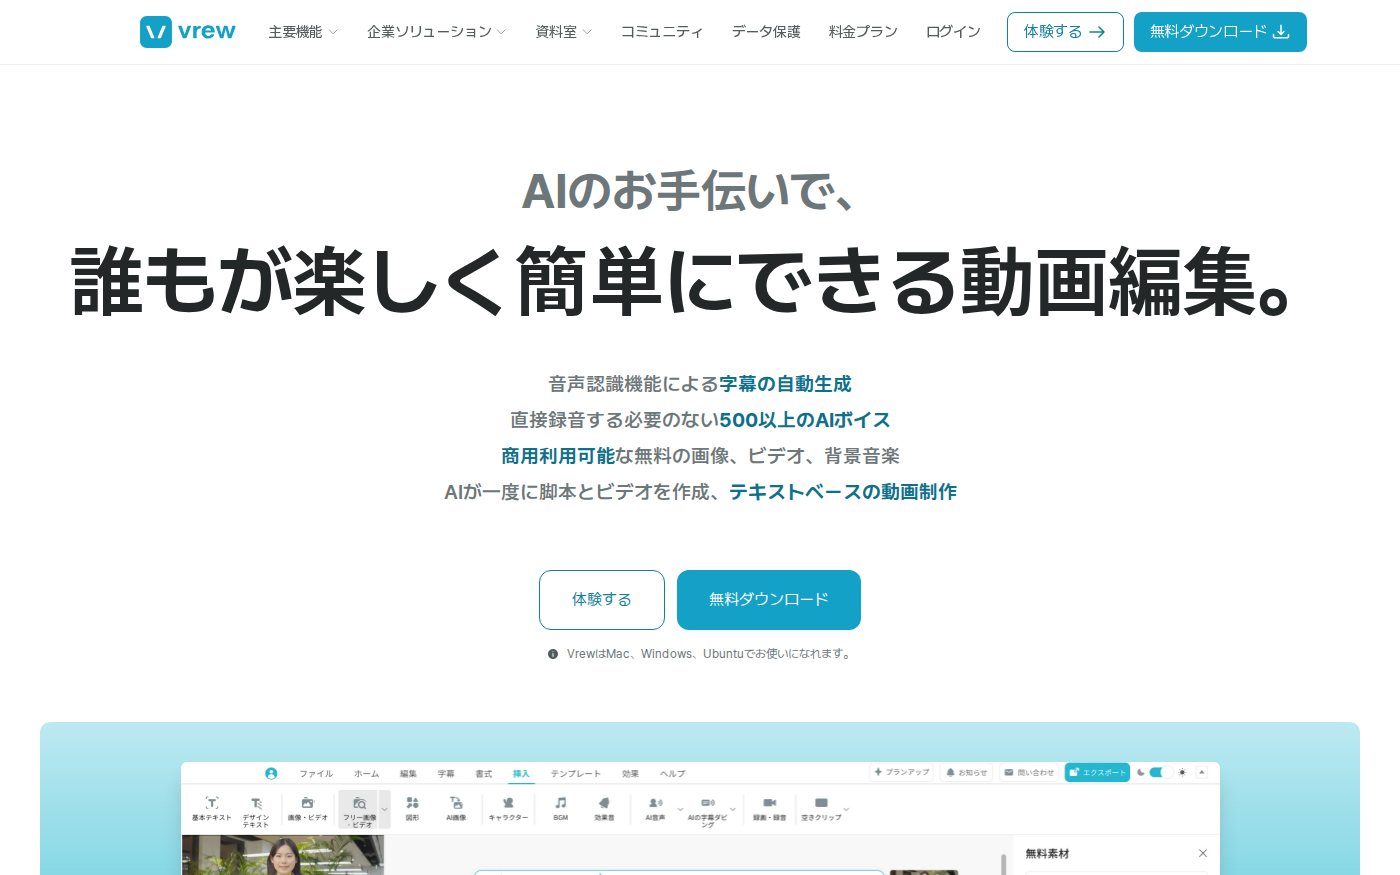
Vrewの使い方 — 無料版で自動字幕を作る手順と料金
確認日: 2026-08-12 · AI動画ツール Vrewは、動画の音声を文字に変換し、その文字を直す感覚で字幕とカットを整えられる動画編集ツールです。字幕付きの解説動画、インタビュー、講義、YouTube動画を作りたいものの、一般的なタイムライン編集が難しく感じる人に向いています。…